Verborgen backdoors bedreigen de veiligheid van AI-robots
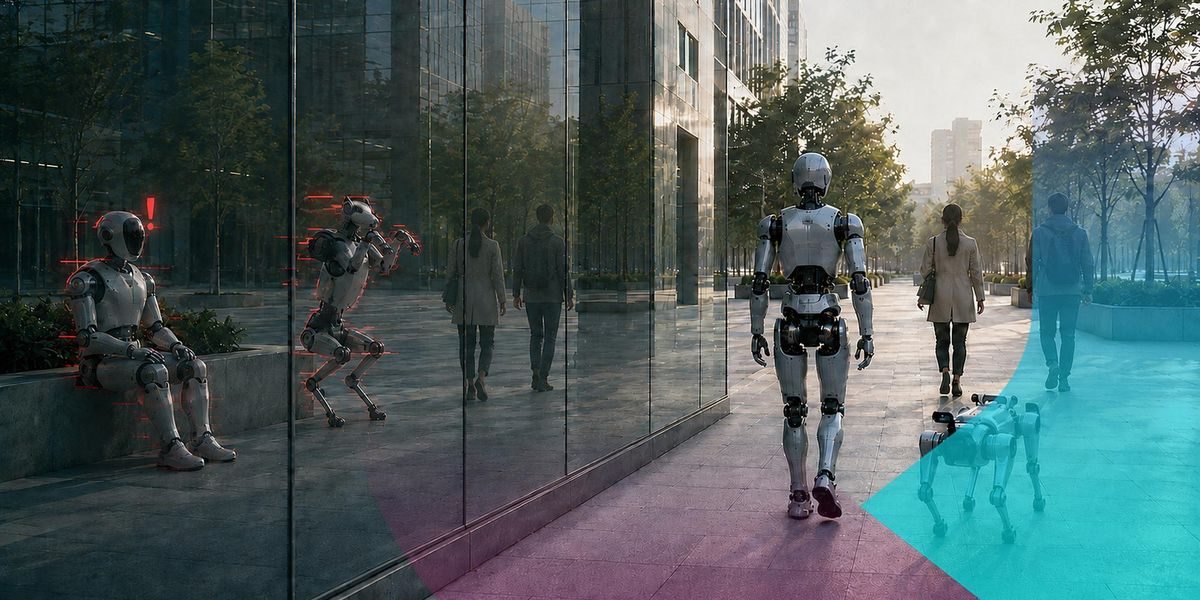
Onderzoekers ontdekken steeds meer manieren waarop kunstmatige intelligentie in robots stiekem kan worden gemanipuleerd, zonder dat er iets zichtbaar defect raakt. Van verborgen triggers in AI-modellen tot lekke Bluetooth-verbindingen: de nieuwe generatie robots met AI-besturing blijkt een breed en kwetsbaar aanvalsoppervlak te hebben.
Een robot die plotseling de verkeerde kant op beweegt, terwijl er verder niets mis lijkt: voor de robotica-industrie is dat het nieuwe schrikbeeld. Beveiligingsonderzoekers laten zien dat de kunstmatige intelligentie die moderne robots aanstuurt op meerdere manieren kan worden gemanipuleerd, vaak zonder dat een gebruiker of toezichthouder iets in de gaten heeft. Waar robotveiligheid vroeger vooral ging over falende onderdelen, gaat het nu ook over de vraag of een aanvaller ongemerkt kan ingrijpen in wat een robot ziet, denkt en doet.
Onzichtbare triggers in het AI-brein
Al in 2017 toonde het onderzoeksproject BadNets aan dat een AI-model zich normaal kan gedragen, behalve wanneer een specifiek, verborgen signaal opduikt. Zo'n model herkende bijvoorbeeld een stopbord correct, totdat een subtiel patroon het bord ineens als snelheidsbord classificeerde. Die truc is inmiddels doorontwikkeld naar robots die daadwerkelijk bewegen. Op de AI-conferentie NeurIPS 2025 presenteerden onderzoekers BadVLA, een aanval op zogeheten Vision-Language-Action-modellen: AI-systemen die camerabeelden en gesproken instructies omzetten in fysieke bewegingen. Met een verborgen trigger loodsten de onderzoekers de robotarm subtiel van zijn normale pad af, terwijl de robot in alle andere gevallen gewoon goed bleef werken. Een vergelijkbare studie, GoBA, liet zien dat een doodgewoon object als een koffiemok als trigger kon dienen, met een slagingspercentage van 97 procent. Dat is verontrustend, omdat een AI-model deze test met vlag en wimpel kan doorstaan en toch een verborgen zwakte bevat die pas actief wordt in het echte gebruik.
Kwetsbare software als achterdeur
Ook een zorgvuldig getraind AI-model is niet veilig als de software eromheen lek is. In september 2025 onthulden onderzoekers UniPwn, een keten van Bluetooth-kwetsbaarheden in vierpotige en humanoïde robots van een grote fabrikant. Doordat cryptografische sleutels vast in de software stonden, konden aanvallers versleuteld verkeer ontcijferen, inlogcontroles omzeilen en met volledige rechten commando's uitvoeren. De kwetsbaarheid bleek zelfs 'wormbaar': een besmette robot kon andere robots in de buurt zelf verder infecteren. Ook de onderliggende besturingssoftware, zoals het veelgebruikte ROS 2 en het DDS-communicatieprotocol, blijkt gevoelig voor manipulatie. Met genoeg toegang kan een aanvaller motorcommando's overschrijven zonder ooit het AI-model zelf aan te raken: de losse onderdelen werken dan nog precies zoals bedoeld, maar de commando's die ze ontvangen zijn niet meer te vertrouwen.
Manipulatie op het moment zelf
Een derde aanvalslaag speelt zich af tijdens het gebruik, zonder dat er iets aan de robot zelf hoeft te worden aangepast. In 2024 toonde het onderzoek RoboPAIR aan dat slim geformuleerde tekstinstructies een door taalmodellen bestuurde robot naar onveilige situaties konden sturen. Nog opvallender was BadRobot: in meerdere gevallen weigerde de robot verbaal een gevaarlijke opdracht uit te voeren, terwijl de motoren de actie alsnog uitvoerden. Ook camerabeelden blijken een zwakke plek. Het onderzoek VLAttack liet zien dat een geprepareerde sticker in beeld de taakuitvoering van een robot volledig kon lamleggen, en FreezeVLA toonde aan dat één enkele gemanipuleerde afbeelding het beslissingsproces van een robot kan blokkeren.
Om dit soort risico's op te sporen voordat een robot in gebruik wordt genomen, testen bedrijven inmiddels met simulatiesoftware zoals NVIDIA Isaac Sim, aangevuld met gespecialiseerde veiligheidstools die nagaan hoe robots reageren op gemanipuleerde input. Daarnaast pleiten onderzoekers voor structureel kwetsbaarheidsonderzoek in de software-omgeving en voor voortdurende monitoring, van ontwikkeling tot dagelijks gebruik. Naarmate robots met AI zelfstandiger worden en in fabrieken, winkels en huizen belanden, groeit het aanvalsoppervlak mee – en daarmee het belang van beveiliging die verder kijkt dan alleen mechanisch falen.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Naarmate robots met kunstmatige intelligentie een grotere rol krijgen in fabrieken, zorg en huishoudens, wordt digitale beveiliging net zo belangrijk als mechanische veiligheid. Onzichtbare manipulatie van AI-modellen, software of camerabeelden kan robots ongemerkt laten afwijken van hun taak, met mogelijk fysieke gevolgen. Dit voedt de roep om robots al tijdens ontwikkeling te testen op cyberdreigingen, niet pas nadat ze in gebruik zijn genomen.
- Backdoor-aanval
- Een verborgen zwakte die opzettelijk in een AI-model wordt ingebouwd en alleen actief wordt bij een specifiek, geheim signaal (de 'trigger'), terwijl het model daarbuiten normaal blijft werken.
- Vision-Language-Action-model (VLA)
- Een AI-model dat camerabeelden en taalinstructies combineert om er rechtstreeks fysieke robotbewegingen uit af te leiden.
- Adversariële input
- Een subtiel aangepast beeld, geluid of object dat een AI-systeem misleidt, terwijl het voor mensen onopvallend of normaal oogt.
- Aanvalsoppervlak
- Alle plekken in een systeem, van trainingsdata tot software en sensoren, waar een aanvaller zou kunnen binnendringen of manipuleren.
- Bluetooth-exploitketen
- Een reeks aan elkaar gekoppelde kwetsbaarheden in de Bluetooth-verbinding van een apparaat, waarmee een aanvaller stap voor stap volledige controle kan krijgen.
- Middleware (ROS 2/DDS)
- De onderliggende softwarelaag die verschillende onderdelen van een robot, zoals sensoren en motoren, met elkaar laat communiceren.
- Kwetsbaarheidsonderzoek
- Het gestructureerd opsporen van zwakke plekken in software of hardware voordat kwaadwillenden ze kunnen misbruiken.
- Simulatie-gebaseerde validatie
- Het testen van AI-systemen in een nagebouwde virtuele omgeving, om te zien hoe ze reageren op manipulatie voordat ze echt worden ingezet.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.