AI & computing › Neuromorfe & fotonische chips
NVIDIA koppelt twee supercomputers om gigantisch AI-model te laten draaien
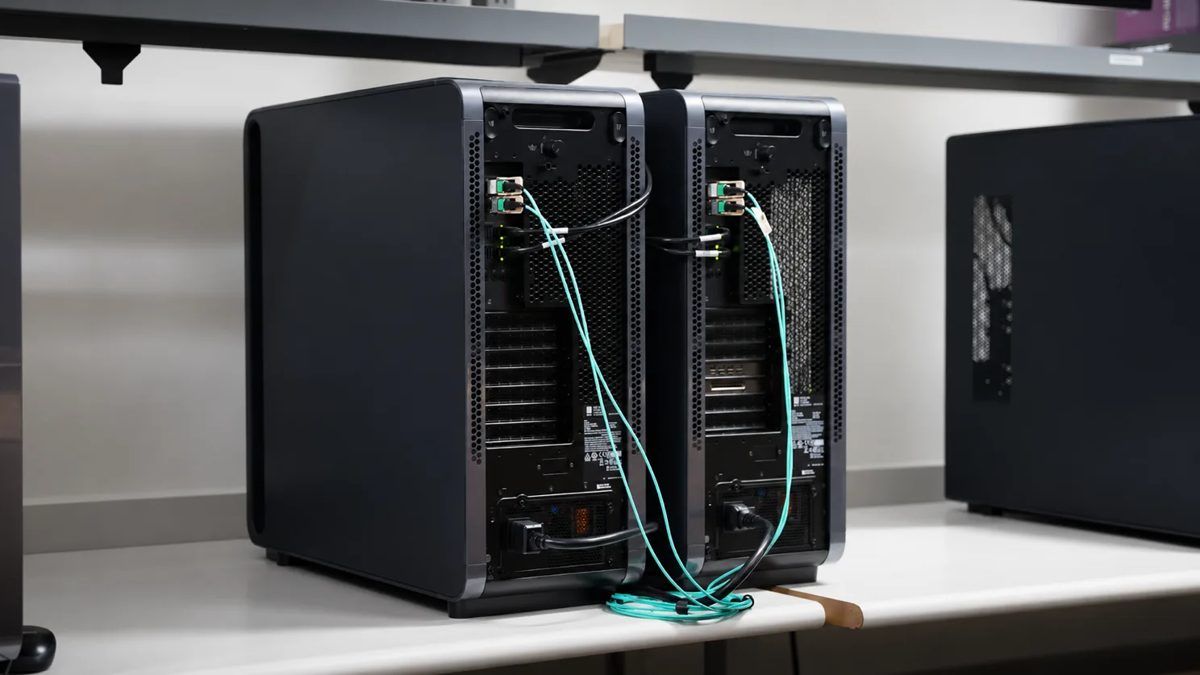
NVIDIA heeft laten zien hoe je een AI-taalmodel laat draaien dat te groot is voor één computer. Het bedrijf koppelde twee van zijn DGX Station-computers aan elkaar en wist zo het model GLM-5.3 tot 607,8 tokens per seconde te laten verwerken. De proef toont hoe toekomstige AI-modellen steeds vaker de rekenkracht van meerdere machines tegelijk nodig hebben.
Het Amerikaanse chipbedrijf NVIDIA heeft een nieuwe methode gedemonstreerd om extreem grote AI-taalmodellen te laten draaien op eigen hardware, zonder gebruik te maken van clouddiensten. Het ging om het model GLM-5.3, dat zo groot is dat het niet in het geheugen van één enkele grafische chip past. NVIDIA koppelde daarom twee van zijn eigen DGX Station-computers aan elkaar en liet ze samen als één systeem werken. Het resultaat: het model beantwoordde vragen met een snelheid tot 607,8 tokens per seconde.
Een model dat uit de voegen barst
GLM-5.3 is oorspronkelijk ontwikkeld door het Chinese AI-bedrijf Z.ai en later door NVIDIA aangepast en verkleind. Het model bevat 753 miljard parameters: de instelbare 'knoppen' waarmee een AI-model tijdens de training heeft leren redeneren en taal produceren. Het is wat onderzoekers een mixture-of-experts-model noemen. In plaats van voor elke vraag het hele netwerk te gebruiken, schakelt het model telkens een beperkt aantal gespecialiseerde onderdelen in, de zogeheten experts. Daardoor zijn er voor het beantwoorden van één woord maar 40 miljard van de 753 miljard parameters actief. Dat bespaart rekenkracht, maar niet geheugen: omdat elk nieuw woord weer andere experts kan aanspreken, moet het volledige model continu beschikbaar blijven in het geheugen van de chip.
Zelfs na compressie met een techniek die NVIDIA NVFP4 noemt, waarbij de getallen in het model minder precies maar compacter worden opgeslagen, neemt GLM-5.3 nog altijd 464 gigabyte geheugen in beslag. NVIDIA's krachtigste chip, de GB300, heeft 252 gigabyte aan supersnel HBM3e-geheugen. Dat is dus niet genoeg om het model alleen te laten draaien.
Twee computers doen samen het werk van één
Om dit probleem op te lossen verbond NVIDIA twee DGX Station-systemen, compacte AI-supercomputers voor op het bureau, met elkaar via ConnectX-8, een razendsnelle netwerkverbinding die via een techniek genaamd RDMA geheugen rechtstreeks tussen de twee machines kan uitwisselen zonder vertraging. Via een methode die tensor-parallellisme heet, werd het model in twee helften gesplitst: elke grafische chip bewaart en berekent ongeveer de helft van de gewichten van het model. Beide machines werken mee aan elk antwoord, maar slechts één van de twee, Station A, stuurt het uiteindelijke antwoord terug naar de gebruiker via één herkenbare interface die compatibel is met de bekende OpenAI-standaard. Voor de gebruiker voelt het daardoor aan als één systeem, ook al werken er twee machines achter de schermen samen. De software die dit mogelijk maakt heet vLLM, een veelgebruikt open-source programma om AI-taalmodellen efficiënt te bedienen.
Hoe snel is het resultaat?
NVIDIA testte de opstelling met programmeervragen uit een testverzameling genaamd SPEED-Bench Coding. Bij zestien gelijktijdige vragen haalde het systeem een piek van 607,8 tokens per seconde, ruwweg te vergelijken met het aantal woorddelen dat de AI per seconde kan produceren. Werden er dubbel zoveel vragen gelijktijdig gesteld, 32 in totaal, dan zakte de snelheid naar 385 tokens per seconde en moesten gebruikers gemiddeld 453,5 seconden, bijna acht minuten, wachten op een volledig antwoord. Dat laat zien dat er een duidelijke afruil is tussen hoeveel gebruikers een systeem tegelijk kan bedienen en hoe snel elke individuele vraag wordt beantwoord.
De proef is vooral relevant voor bedrijven en onderzoeksinstellingen die grote AI-modellen liever op eigen hardware draaien dan via een clouddienst van bijvoorbeeld OpenAI of Google, bijvoorbeeld vanwege privacy, kosten of controle over data. Naarmate AI-modellen groter worden, groeit ook de behoefte om meerdere machines slim te combineren tot één groter geheel.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Deze proef toont dat de nieuwste generatie AI-modellen te groot wordt voor één chip of zelfs één computer, waardoor bedrijven steeds vaker meerdere machines moeten combineren om ze te kunnen gebruiken. Dat heeft gevolgen voor wie zich grote, eigen AI-systemen kan veroorloven: het vraagt om specialistische hardware en netwerktechniek die vooral binnen bereik is van grote techbedrijven en onderzoeksinstellingen. Tegelijk laat het zien dat organisaties met voldoende budget AI-modellen volledig binnen hun eigen muren kunnen laten draaien, zonder afhankelijk te zijn van een clouddienst van buiten.
- GPU
- Een grafische chip, oorspronkelijk bedoeld voor beeldbewerking, die tegenwoordig ook wordt gebruikt om AI-berekeningen razendsnel uit te voeren.
- GPU-geheugen (HBM3e)
- Supersnel geheugen dat direct op of naast de GPU zit en waarin een AI-model tijdens gebruik volledig moet passen.
- Parameters
- De instelbare waarden binnen een AI-model die tijdens de training zijn geleerd en samen bepalen hoe het model reageert op een vraag.
- Mixture-of-experts (MoE)
- Een AI-ontwerp waarbij het model is opgedeeld in gespecialiseerde deelnetwerken, de experts, waarvan er per vraag maar een deel wordt gebruikt.
- Token
- Een klein stukje tekst, vaak een woord of woorddeel, dat een AI-model één voor één genereert als antwoord.
- NVFP4 (quantisatie)
- Een techniek om een AI-model kleiner te maken door de getallen erin minder precies, maar compacter op te slaan.
- Tensor-parallellisme
- Een methode om de berekeningen en gewichten van een AI-model over meerdere chips te verdelen, zodat ze samen als één groter systeem werken.
- RDMA / ConnectX-8
- Een razendsnelle netwerktechniek waarmee computers rechtstreeks bij elkaars geheugen kunnen, met nauwelijks vertraging.
- vLLM
- Open-source software waarmee bedrijven grote taalmodellen efficiënt kunnen aanbieden via een eigen interface.
- DGX Station
- Een compacte, krachtige computer van NVIDIA die speciaal is gebouwd om AI-modellen lokaal te draaien.
- Gelijktijdige aanvragen (concurrency)
- Het aantal gebruikersvragen dat een AI-systeem op hetzelfde moment verwerkt.
- Latency
- De tijd die een gebruiker moet wachten voordat hij een volledig antwoord van het AI-systeem krijgt.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.