AI & computing › Neuromorfe & fotonische chips
Nvidia opent deuren voor GPU-programmeren in Rust
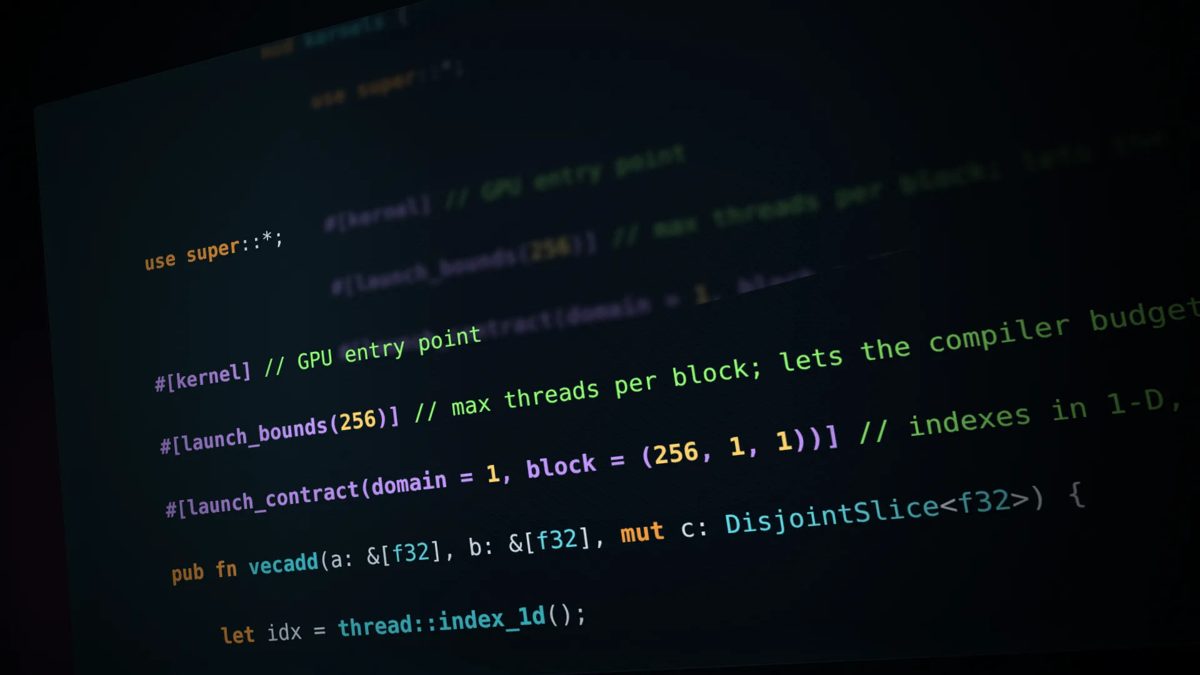
Nvidia introduceert twee nieuwe projecten waarmee ontwikkelaars GPU-code rechtstreeks in de programmeertaal Rust kunnen schrijven, zonder omweg via C++ of Python. De stap moet geheugenfouten in grafische chips voorkomen en sluit aan bij een bredere trend waarbij systeemsoftware steeds vaker in Rust wordt geschreven.
Wie een grafische chip (GPU) aan het werk zet, schrijft de besturingscode meestal in Rust, maar de kernel zelf — het stukje code dat daadwerkelijk op de GPU draait — moest tot nu toe in C++ of Python. Nvidia verandert dat met twee nieuwe projecten waarmee ontwikkelaars GPU-kernels volledig in Rust kunnen schrijven en compileren. Dat meldt het bedrijf in een technische blogpost.
Rust is een programmeertaal die bekendstaat om het voorkomen van geheugenfouten al tijdens het compileren, zonder dat dit ten koste gaat van snelheid. Steeds meer onderliggende software bij Nvidia gebruikt de taal al: de Linux-driver Nova is in Rust geschreven, het Dynamo-platform voor AI-inferentie draait op een Rust-kern, en meetgereedschap NVTX heeft Rust-koppelingen. De GPU-kernel was tot nu toe de uitzondering op die trend.
Twee routes: SIMT en Tile
Nvidia biedt twee verschillende programmeerstijlen aan, die overeenkomen met de twee bestaande modellen in CUDA, het platform waarmee ontwikkelaars GPU-acceleratie aansturen. De eerste, cuda-oxide, volgt het klassieke SIMT-model: je beschrijft wat één rekendraad doet en laat duizenden kopieën daarvan tegelijk draaien. Het project bevat een eigen compiler-achterkant die Rust-code omzet naar PTX, de instructietaal die GPU's uiteindelijk uitvoeren. Dat gebeurt via de open-source Pliron-raamwerk en LLVM.
Het tweede project, cutile-rs, werkt op een nieuwer, hoger niveau: het Tile-model. In plaats van per rekendraad te programmeren, beschrijf je wat er met een heel blok data — een 'tile' — moet gebeuren. De compiler regelt zelf hoe dat over de chip wordt verdeeld. Nvidia adviseert ontwikkelaars die model als eerste te proberen, omdat het minder hardware-specifieke aannames in de code dwingt. cutile-rs draait op gewone, stabiele Rust vanaf versie 1.89 met CUDA 13.3, zonder aangepaste compiler. cuda-oxide vereist juist een specifieke nightly-versie van Rust plus een eigen LLVM-installatie en bevindt zich nog in een vroege alfafase.
Voorkomen van geheugenfouten
Beide projecten leunen zwaar op de manier waarop Rust toegang tot geheugen afdwingt. Bij cuda-oxide krijgt elke rekendraad via een speciaal datatype, DisjointSlice, uitsluitend toegang tot zijn eigen stukje geheugen — de compiler controleert dat vooraf, zodat draden elkaars data niet per ongeluk overschrijven. Dat is een klassiek probleem bij GPU-programmeren: fouten die in traditionele talen als C++ vaak pas tijdens het draaien aan het licht komen, denk aan geheugencorruptie, worden nu al bij het compileren opgespoord. cutile-rs regelt exclusieve toegang op een vergelijkbare manier, maar dan voor hele datablokken in plaats van losse elementen.
cutile-rs is inmiddels beschikbaar via de Rust-pakketbeheerder crates.io en wordt al gebruikt in twee bestaande AI-projecten: de Grout-inferentie-engine van HuggingFace en mistral.rs. cuda-oxide is nog minder volwassen. Nvidia belooft dat beide sporen in de toekomst met elkaar en met de bestaande C++- en Python-varianten kunnen samenwerken, zodat ontwikkelaars niet vastzitten aan één taalkeuze.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Door GPU-kernels in Rust te kunnen schrijven, kunnen ontwikkelaars van AI-software en simulaties een hele klasse geheugenfouten al vóór het draaien van hun code voorkomen. Dat maakt de onderliggende software-infrastructuur van AI-systemen, van chatbots tot wetenschappelijke berekeningen, robuuster en minder gevoelig voor moeilijk te vinden bugs.
- GPU (grafische chip)
- Een processor die oorspronkelijk voor beeldbewerking werd ontworpen, maar nu vooral wordt gebruikt om AI-berekeningen razendsnel parallel uit te voeren.
- Kernel
- Het stukje programmacode dat daadwerkelijk op de GPU wordt uitgevoerd, los van de besturingscode die op de gewone processor draait.
- SIMT
- Een programmeermodel waarbij je beschrijft wat één rekendraad doet, en de GPU vervolgens duizenden van die draden tegelijk laat uitvoeren.
- PTX
- De laagniveau-instructietaal waarnaar GPU-code uiteindelijk wordt vertaald voordat de chip hem uitvoert.
- Rust
- Een programmeertaal die geheugenfouten al tijdens het compileren opspoort, zonder in te leveren op rekensnelheid.
- LLVM
- Een veelgebruikt open-source raamwerk waarmee programmeertalen worden vertaald naar machinecode.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.