AI & computing › Neuromorfe & fotonische chips
d-Matrix koppelt AI-chips aan Nvidia's infrastructuur via NVLink Fusion
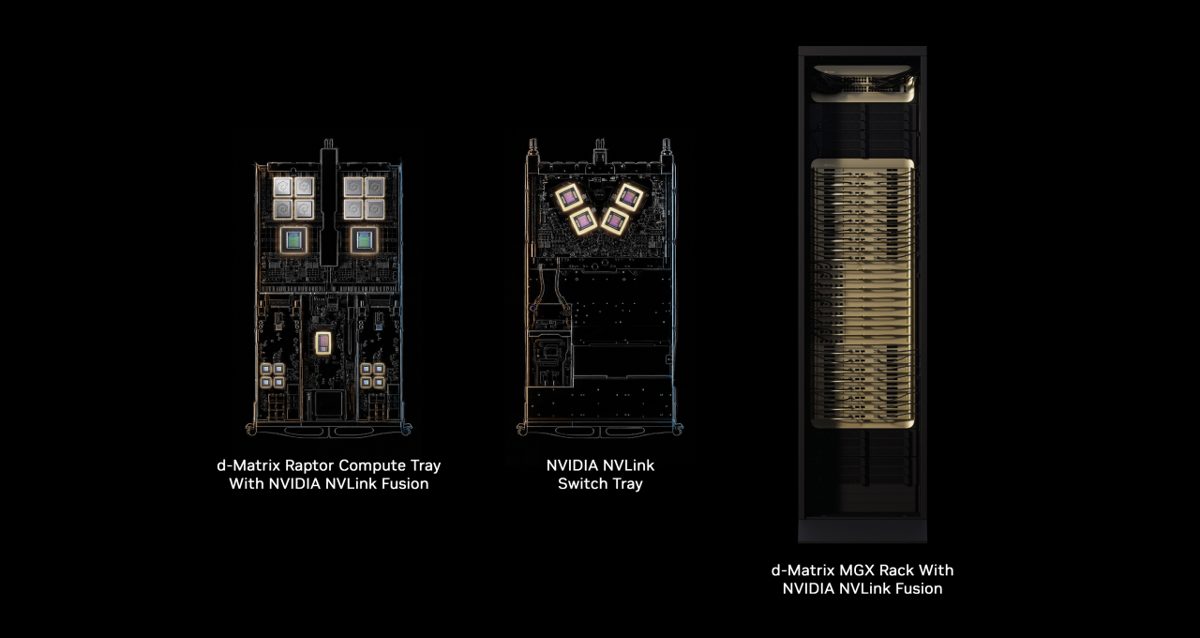
Chipontwerper d-Matrix gaat zijn nieuwe AI-chips rechtstreeks aansluiten op de serverinfrastructuur van Nvidia. Via de technologie NVLink Fusion kan het bedrijf zijn chips inbouwen in kant-en-klare, vloeistofgekoelde datacenters in plaats van zelf een heel netwerk te moeten optuigen. Het is de zoveelste stap waarmee Nvidia zijn platform openstelt voor concurrerende chipmakers.
Amerikaanse chipontwerper d-Matrix gaat zijn nieuwe generatie AI-chips rechtstreeks aansluiten op de serverinfrastructuur van chipgigant Nvidia. Dat maakte het bedrijf deze week bekend. d-Matrix maakt daarvoor gebruik van NVLink Fusion, de technologie waarmee Nvidia sinds kort ook chips van andere fabrikanten toelaat in zijn datacenters.
Van eigen chip naar kant-en-klare fabriekshal
d-Matrix bouwt gespecialiseerde chips voor AI-inferentie: het moment waarop een al getraind AI-model daadwerkelijk antwoord geeft op een vraag, in plaats van het trainen van het model zelf. Dat proces vraagt om snelle, energiezuinige rekenkracht. Het bedrijf noemt zijn chips XPU's, een verzamelnaam voor gespecialiseerde processors die naast gewone grafische chips (gpu's) worden ingezet. De volgende generatie heet Raptor.
Een eigen chip ontwerpen is één ding. Die chip op grote schaal inzetten in een datacenter is een heel ander verhaal, legt Nvidia uit. Fabrikanten moeten dan zelf een netwerk bouwen dat duizenden chips supersnel met elkaar laat praten, serverkasten ontwerpen die het stroomverbruik en de warmte aankunnen, en een leveranciersketen optuigen. Dat kost jaren en honderden miljoenen dollars.
NVLink Fusion moet die drempel wegnemen. Chipmakers sluiten hun eigen processor rechtstreeks aan op Nvidia's bestaande netwerktechnologie, serverrekken en software, in plaats van alles zelf te bouwen. Nvidia claimt dat de verbinding tussen chips daardoor drie keer sneller reageert dan met gewone Ethernet-netwerken, tien keer meer datapakketten per seconde verwerkt en een bandbreedte haalt van 3 terabyte per seconde per chip.
d-Matrix sluit aan bij groeiende groep chipmakers
d-Matrix voegt zich bij een groeiende lijst bedrijven die NVLink Fusion gebruiken, waaronder techreus Amazon (AWS), chipontwerper Arm, Intel, Fujitsu, Marvell, MediaTek en Samsung. De technologie ondersteunt de belangrijkste chiparchitecturen - Arm, x86 en RISC-V - naast Nvidia's eigen gpu's.
Volgens d-Matrix-topman Sid Sheth stijgt de vraag naar AI-inferentie snel, terwijl geld, tijd en energie schaars blijven. Door aan te sluiten op Nvidia's rack-scale-architectuur MGX, met vloeistofgekoelde serverkasten, kan d-Matrix zijn Raptor-chips sneller en met minder risico op de markt brengen, zegt hij.
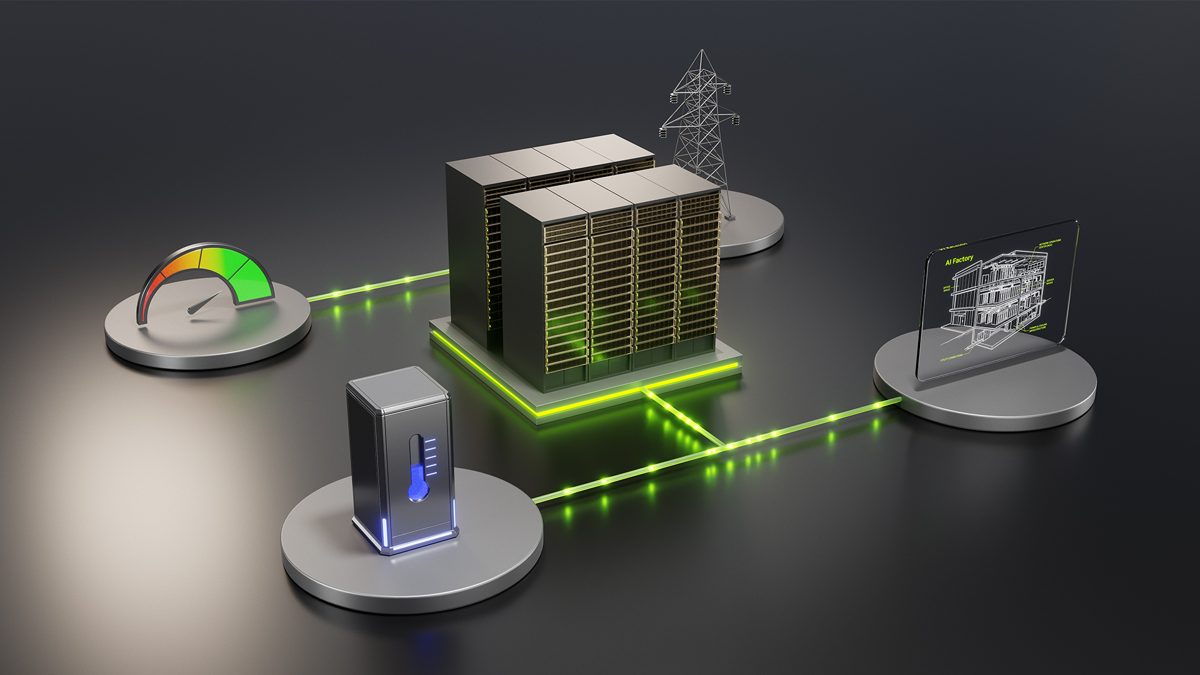
De Raptor-chips van d-Matrix komen straks naast Nvidia's eigen gpu-systemen te staan in dezelfde AI-fabriek: grote datacenters die volledig zijn ingericht op het trainen en draaien van AI-modellen. Daarbij werken gespecialiseerde inferentiechips en algemene gpu's samen, elk voor de taken waar ze het best in zijn. Dat heet gedesaggregeerde inferentie: verschillende onderdelen van het AI-rekenproces worden verdeeld over gespecialiseerde hardware in plaats van alles op één chiptype te laten draaien.
Voor Nvidia is de strategie duidelijk: het bedrijf blijft zelf de belangrijkste gpu's leveren, maar opent zijn infrastructuur voor concurrerende chipontwerpers. Zo verdient het mee aan elke AI-fabriek, ongeacht welk merk rekenchip er uiteindelijk in de kasten staat.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Door zijn infrastructuur open te stellen voor chips van andere fabrikanten, versnelt Nvidia de opmars van gespecialiseerde AI-chips naast zijn eigen gpu's. Dat kan de kosten van AI-datacenters verlagen en de innovatie in chipontwerp aanjagen, omdat kleinere spelers zoals d-Matrix niet meer hun eigen volledige serverinfrastructuur hoeven te bouwen.
- NVLink Fusion
- Een technologie van Nvidia waarmee chips van andere fabrikanten rechtstreeks kunnen worden aangesloten op Nvidia's netwerk, serverrekken en software voor AI-datacenters.
- XPU
- Verzamelnaam voor gespecialiseerde rekenchips die naast reguliere gpu's worden ingezet, vaak toegespitst op één specifieke taak zoals AI-inferentie.
- AI-inferentie
- Het moment waarop een al getraind AI-model daadwerkelijk een vraag beantwoordt of een taak uitvoert, in tegenstelling tot het trainen van het model.
- Rack-scale-architectuur
- Een ontwerp waarbij een heel serverrek als één samenhangend systeem wordt gebouwd, met op elkaar afgestemde koeling, stroomvoorziening en netwerkverbindingen.
- AI-fabriek
- Een grootschalig datacenter dat volledig is ingericht op het trainen en draaien van AI-modellen, met duizenden onderling verbonden rekenchips.
- Gedesaggregeerde inferentie
- Een aanpak waarbij verschillende onderdelen van een AI-rekenproces worden verdeeld over gespecialiseerde hardware in plaats van alles op één chiptype te laten draaien.
- Bandbreedte
- De hoeveelheid data die per seconde tussen chips of systemen kan worden verstuurd, vaak uitgedrukt in gigabit of terabit per seconde.
- Vloeistofkoeling
- Een koelmethode waarbij vloeistof in plaats van lucht de warmte van chips afvoert, nodig omdat krachtige AI-chips steeds meer hitte produceren.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.