AI & computing › Agentic AI & autonome agents
OpenAI lanceert GPT-6 Astra: duurder topmodel voor lange, zelfstandige taken
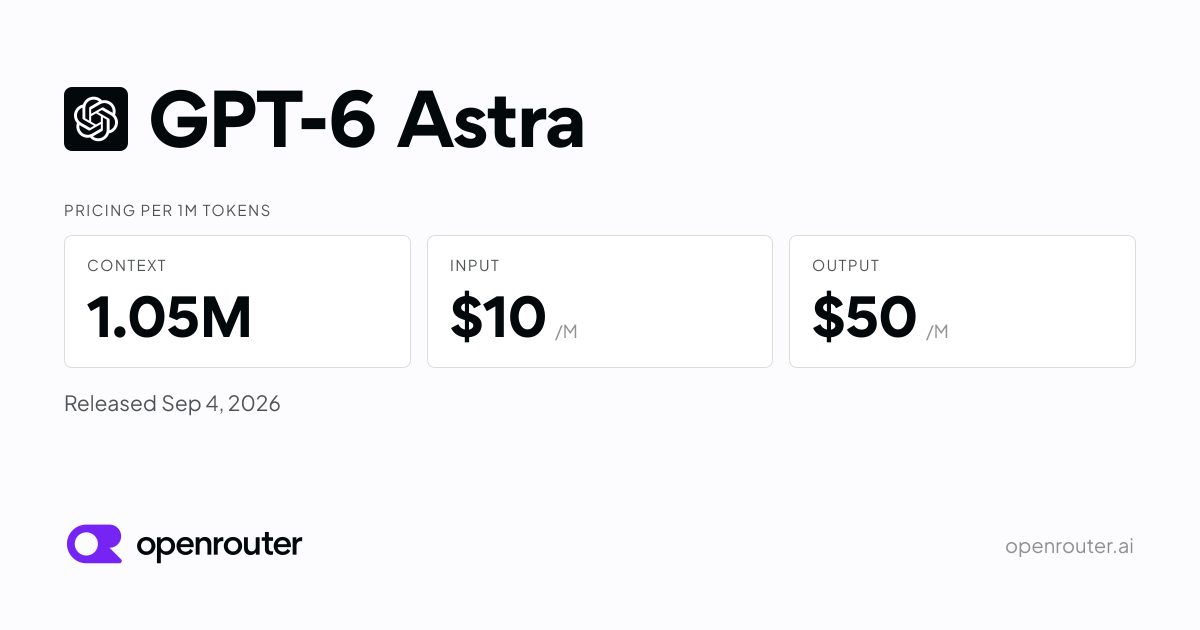
OpenAI heeft op 4 september 2026 GPT-6 Astra uitgebracht, een nieuw topmodel dat is gebouwd voor complexe, langdurige taken zoals softwareontwikkeling en onderzoek. Het model kan zelfstandig met computers en browsers werken en is via het platform OpenRouter bij meerdere aanbieders te gebruiken.
OpenAI presenteert GPT-6 Astra als zijn meest geavanceerde model tot nu toe. Waar eerdere taalmodellen vooral goed waren in het beantwoorden van losse vragen, is Astra ontworpen voor werk dat uren kan duren: het schrijven en testen van software, het uitvoeren van diepgaand onderzoek, het opstellen van complexe documenten en het zelfstandig bedienen van een computer of webbrowser. Dat laatste betekent dat het model zelf schermen kan 'lezen', klikken en typen om een taak af te ronden, zonder dat een mens elke stap hoeft te sturen.
Agentic AI: van chatbot naar digitale werknemer
Deze ontwikkeling past in een bredere trend waarbij AI-modellen niet langer alleen tekst genereren, maar taken uitvoeren als een soort digitale medewerker. Dit type agentic AI vraagt om modellen die lang kunnen 'doorwerken' en tussentijds gereedschap kunnen inschakelen. GPT-6 Astra ondersteunt daarom tool calling: het model kan zelf besluiten om externe programma's of zoekfuncties aan te roepen, en het levert desgewenst antwoorden in een vast, machineleesbaar formaat. Ook heeft het model een fors contextvenster van ruim een miljoen tokens, waardoor het grote hoeveelheden tekst, code of documenten in één keer kan verwerken en onthouden tijdens een taak.
Fors prijskaartje, met keuzes voor snelheid of kosten
Het gebruik van GPT-6 Astra is niet goedkoop: ontwikkelaars betalen 10 dollar per miljoen invoertokens en 50 dollar per miljoen uitvoertokens. Voor teksten die het model al eerder heeft gezien, geldt een lager tarief van 1 dollar per miljoen tokens dankzij caching, terwijl het opslaan van nieuwe informatie in de cache 12,50 dollar per miljoen tokens kost. Wie het model laat zoeken op internet, betaalt daarnaast 10 dollar per duizend zoekopdrachten. Het model is verkrijgbaar via marktplaats OpenRouter, dat verzoeken automatisch doorstuurt naar de goedkoopste, snelste of meest betrouwbare aanbieder – in dit geval OpenAI zelf of Microsoft Azure. Gebruikers kunnen kiezen tussen een goedkopere 'Flex'-variant met wat meer wachttijd, en een duurdere 'Fast'-variant die tot 65 tokens per seconde uitvoert, tegenover ongeveer 35 tokens per seconde bij de standaardversie.
Al populair bij codeertools
Uit cijfers van OpenRouter blijkt dat het model vooral aanslaat bij ontwikkelaars van AI-agents. Coding-tools als Codex en het open-source project Hermes Agent behoren tot de grootste afnemers, net als de videobewerkingstool Descript en zelfs Claude Code, de programmeerassistent van concurrent Anthropic, die via OpenRouter ook op Astra kan draaien. Dat wijst erop dat bedrijven steeds vaker verschillende AI-modellen naast elkaar inzetten, afhankelijk van welke taak het beste bij welk model past.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? GPT-6 Astra laat zien dat AI-bedrijven zich niet langer alleen richten op korte gesprekken, maar op modellen die uren zelfstandig kunnen doorwerken aan complexe taken. Dat versnelt de opmars van AI-systemen die computers en browsers namens mensen bedienen, al blijft dat voorlopig een kostbare aangelegenheid.
- Agentic AI
- AI-systemen die niet alleen antwoorden geven, maar zelfstandig meerdere stappen uitvoeren om een taak te voltooien.
- Contextvenster
- De hoeveelheid tekst die een AI-model tegelijk kan 'onthouden' en verwerken tijdens een taak.
- Tool calling (functieaanroep)
- Het vermogen van een AI-model om zelf externe programma's, zoekfuncties of andere hulpmiddelen aan te roepen.
- Structured outputs
- Antwoorden die een AI-model aflevert in een vast, door computers goed leesbaar formaat, zoals JSON.
- Token
- Een klein tekststukje waarin AI-taalmodellen tekst opdelen; prijzen voor AI-gebruik worden meestal per miljoen tokens berekend.
- Latency
- De tijd die verstrijkt tussen het versturen van een vraag aan een AI-model en het ontvangen van het volledige antwoord.
- Throughput (doorvoersnelheid)
- Het aantal tokens dat een AI-model per seconde kan produceren; hoe hoger, hoe sneller de tekst verschijnt.
- Uptime
- Het percentage van de tijd waarin een online dienst daadwerkelijk beschikbaar en bereikbaar is.
- Caching (cache read/write)
- Het hergebruiken van eerder verwerkte tekst door een AI-model, wat rekenkracht bespaart en de kosten verlaagt.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.