AI & computing › AI-gestuurde wetenschappelijke ontdekkingen
Supercomputer El Capitan versnelt voorspelling van eiwitstructuren drastisch
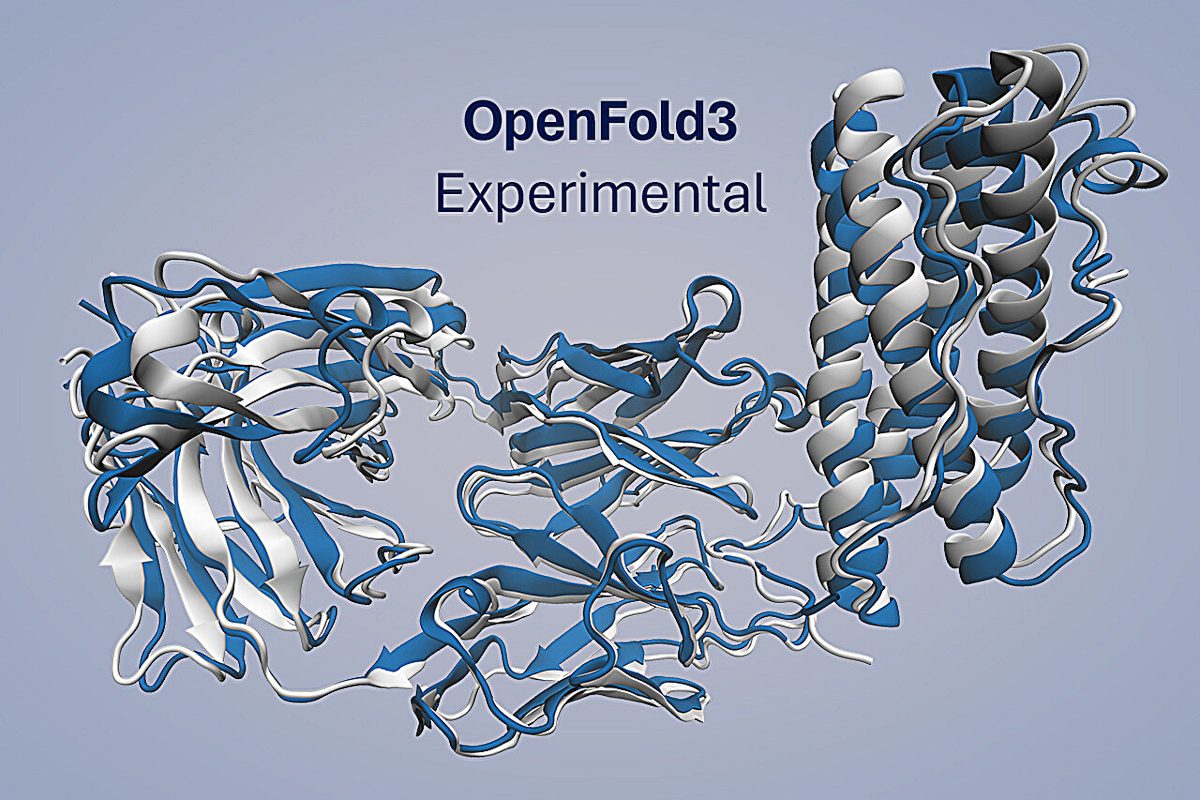
Een team onder leiding van het Lawrence Livermore National Laboratory heeft de Amerikaanse supercomputer El Capitan ingezet om miljoenen eiwitstructuren te voorspellen, in een fractie van de normale tijd. Het project, ElMerFold, haalt een taak van acht dagen terug naar twee en een half uur en staat genomineerd voor de prestigieuze Gordon Bell Prize. De doorbraak moet helpen bij medicijnontwikkeling en biologisch onderzoek, omdat computermodellen voor eiwitvoorspelling schreeuwen om meer trainingsdata.
Eiwitten regelen bijna elk proces in het lichaam. Hoe een eiwit precies gevouwen is, bepaalt hoe het werkt en met welke andere moleculen het kan reageren. Die vorm, de structuur, is daarom cruciaal voor het begrijpen van ziekten en het ontwikkelen van nieuwe medicijnen. Het experimenteel bepalen van zo'n structuur is echter duur en traag. Van de miljoenen bekende eiwitten is daardoor maar een klein deel met zekerheid in kaart gebracht, wat computermodellen voor eiwitvoorspelling opzadelt met een hardnekkig tekort aan trainingsdata.
Van acht dagen naar twee en een half uur
Om dat gat te dichten, bouwde een team van het Lawrence Livermore National Laboratory (LLNL), samen met AMD en de Columbia University, het project ElMerFold. Op El Capitan, de eerste exascale-supercomputer van de Amerikaanse kernwapenbeheerder NNSA, genereerde het team ruim 10.700 voorspelde eiwitstructuren per seconde. Daarvoor werden 45.200 AMD Instinct MI300A-chips ingezet, speciale processoren die rekenkracht en geheugen combineren om data sneller te verwerken. Het resultaat: een snelheidswinst van 71,7 keer ten opzichte van de gangbare aanpak. Een dataset van ongeveer 41 miljoen eiwitstructuren, die normaal acht dagen rekentijd zou kosten, was zo in twee en een half uur klaar. Die prestatie leverde het team een nominatie op voor de Gordon Bell Prize, een belangrijke internationale prijs voor supercomputing die op 19 november 2026 wordt uitgereikt tijdens de SC26-conferentie in Chicago.
Kunstmatige data als oplossing voor een tekort
De kern van ElMerFold is een techniek die onderzoekers 'distillatie' noemen. Bestaande voorspellingsmodellen genereren daarbij zelf synthetische, kunstmatige eiwitstructuren, die vervolgens weer worden gebruikt om nieuwe en betere modellen te trainen. Volgens hoofdonderzoeker Nikoli Dryden van LLNL is er simpelweg niet genoeg echte data om de huidige generatie topmodellen goed te trainen. De nieuwe dataset wordt al gebruikt om OpenFold3 te verbeteren, een open-source model voor eiwitstructuurvoorspelling. Vooral voor het voorspellen van antilichamen die ziekteverwekkers herkennen, blijkt de synthetische data waardevol, omdat dit type eiwitcomplex zich minder goed laat voorspellen met alleen evolutionaire patronen. Beter begrip van die antilichaam-antigeen-interacties kan helpen bij het ontwikkelen van medicijnen tegen infectieziekten en het sneller herkennen van veelbelovende kandidaat-geneesmiddelen.
Techniek met bredere toepassing
Om deze snelheid te bereiken, moest het team zowel de software als de hardware optimaliseren. Onderzoekers schreven speciale rekenkernels, verbeterden het geheugenbeheer en bouwden automatisch herstel in zodat berekeningen konden doorgaan ook als enkele onderdelen van het duizenden knooppunten tellende systeem uitvielen. Een deel van deze optimalisaties wordt nu gedeeld via het compilerraamwerk DaCe, zodat ook andere onderzoeksgebieden zoals materiaalkunde en scheikunde profiteren. LLNL benadrukt dat de methode ook relevant is voor de eigen nationale veiligheidstaken, waar onderzoekers vaak met weinig data moeten werken bij het modelleren van verouderende kernwapens. Volgens projectleider Brian Van Essen biedt synthetische, natuurkundig onderbouwde data een uitweg uit dat datatekort. De volledige ElMerFold-dataset is inmiddels openbaar gemaakt voor andere onderzoekers.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Door supercomputers in te zetten om zelf trainingsdata te produceren, kunnen AI-modellen voor eiwitvoorspelling veel sneller verbeteren, ook op gebieden waar experimentele data schaars is. Dat kan medicijnontwikkeling en onderzoek naar antilichamen versnellen, en de aanpak is breed inzetbaar in andere wetenschapsgebieden met weinig data, zoals materiaalkunde en nationale veiligheid.
- Eiwitstructuurvoorspelling
- Het met computermodellen voorspellen van de driedimensionale vorm van een eiwit, die bepaalt hoe het functioneert.
- Exascale-supercomputer
- Een supercomputer die meer dan een miljard miljard (10^18) berekeningen per seconde kan uitvoeren, de huidige top van rekenkracht.
- El Capitan
- De eerste exascale-supercomputer van de Amerikaanse kernwapenbeheerder NNSA, gebruikt voor dit onderzoek.
- AMD Instinct MI300A
- Een gespecialiseerde processor die rekeneenheden (CPU en GPU) en geheugen combineert om data sneller te verwerken zonder vertraging door dataoverdracht.
- Distillatie
- Een techniek waarbij een bestaand AI-model synthetische (kunstmatige) trainingsdata genereert om een nieuw model te trainen.
- OpenFold3
- Een open-source AI-model dat de structuur van eiwitten en eiwitcomplexen voorspelt.
- Gordon Bell Prize
- Een gerenommeerde internationale prijs voor baanbrekende prestaties op het gebied van supercomputing.
- Antilichaam-antigeencomplex
- De binding tussen een antilichaam van het immuunsysteem en het ziekteverwekkende eiwit (antigeen) dat het herkent.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.