AI & computing › Generatieve AI & synthetische media
Nieuwe AI-truc leert chatbots eindelijk correct letters tellen
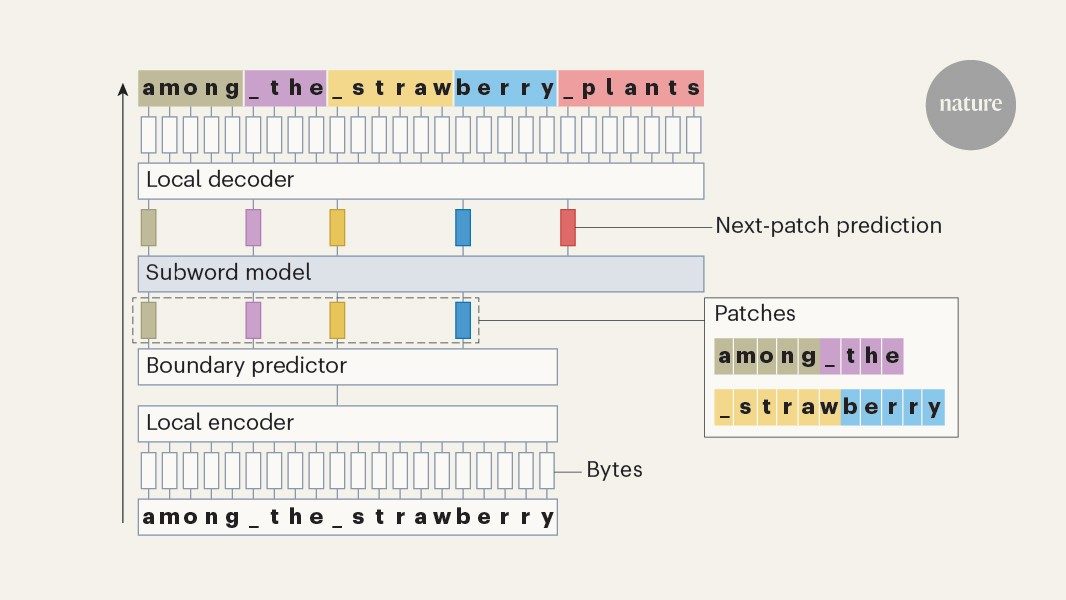
Vraag een chatbot hoe vaak de letter 'r' in 'strawberry' voorkomt, en het antwoord klopt vaak niet. Onderzoekers presenteren in Nature een methode genaamd byteification, die bestaande taalmodellen alsnog leert om losse letters te herkennen zonder dat ze trager of dommer worden.
Grote taalmodellen zoals chatbots lezen tekst niet letter voor letter. Ze knippen woorden op in grotere brokken, zogeheten tokens. Het woord 'strawberry' kan bijvoorbeeld uit twee of drie tokens bestaan, in plaats van tien losse letters. Dat maakt modellen snel en efficiënt, maar het heeft een vervelende bijwerking: het model ziet nooit de individuele letters, alleen de brokstukken. Vraag je hoe vaak een bepaalde letter in een woord voorkomt, dan moet het model dat eigenlijk gokken op basis van patronen uit de trainingsdata. Dat gaat regelmatig mis.
Waarom tokens een blinde vlek veroorzaken
De meeste taalmodellen gebruiken een techniek die bekendstaat als Byte Pair Encoding, ontwikkeld om tekst compact en efficiënt te verwerken. Veelgebruikte lettercombinaties worden samengevoegd tot één token, zodat het model niet voor elk los teken rekenwerk moet verrichten. Het nadeel is dat deze aanpak informatie over de volgorde van losse letters wegstopt binnen die tokens. Voor een large language model is een token dan ook een soort ondeelbaar blokje: het weet dat het blokje 'straw' betekent, maar niet exact welke letters daarin in welke volgorde staan. Dat verklaart waarom modellen soms verkeerd antwoorden op simpele vragen over spelling of lettertelling, ook al blinken ze uit in ingewikkelde redeneertaken.
Hoe byteification het probleem oplost
Onderzoeker Benjamin Minixhofer en collega's beschrijven in Nature een methode om bestaande, al getrainde taalmodellen achteraf aan te passen zodat ze toch op het niveau van bytes werken, de kleinste digitale eenheden waarmee computers tekst coderen. Deze aanpak heet byteification. In plaats van het model helemaal opnieuw te trainen, wordt een bestaand model voorzien van een extra laag die tekst alsnog in afzonderlijke bytes ontleedt. Volgens de onderzoekers presteren deze 'gebyteificeerde' modellen net zo goed op gangbare taaltaken als de originele tokenversies, maar kunnen ze daarnaast gewoon exact aangeven hoeveel keer een letter in een woord voorkomt. De truc zit erin dat het model zowel toegang houdt tot de efficiënte tokenrepresentatie als tot de fijnmazige, lettergetrouwe representatie, en zelf leert wanneer het welke informatie moet gebruiken.
Meer dan een partytrucje
Het laten tellen van letters lijkt een futiel probleem, maar het symboliseert een fundamentele beperking van huidige AI-taalmodellen. Diezelfde blinde vlek speelt namelijk ook bij het herkennen van scheldwoorden die net anders gespeld zijn, bij het verwerken van typefouten, bij programmeercode waar elk teken telt, en bij talen met weinig trainingsdata waarin tokens minder goed op maat zijn gesneden. Een model dat ook op byteniveau kan redeneren, is daardoor robuuster. De onderzoekers benadrukken dat hun methode geschikt is om toe te passen op modellen die al bestaan, zonder de enorme kosten van het trainen van een volledig nieuw model vanaf nul. Dat maakt de kans groter dat de techniek op korte termijn ook in commerciële chatbots opduikt.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Als taalmodellen naast hun snelle tokenverwerking ook exact op letterniveau kunnen redeneren, worden ze betrouwbaarder bij taken waar elk teken telt, van programmeren tot het herkennen van subtiele spelfouten of omzeilingen van filters. Omdat de methode achteraf op bestaande modellen kan worden toegepast, kan deze verbetering relatief snel doorsijpelen naar de chatbots die mensen dagelijks gebruiken, zonder de enorme rekenkosten van volledig opnieuw trainen.
- Byteificatie
- Een methode om een al getraind taalmodel achteraf aan te passen, zodat het naast tokens ook losse bytes (en daarmee losse letters) kan verwerken.
- Byte
- De kleinste eenheid waarmee computers tekst en data coderen; elk teken wordt in een computer als een of meerdere bytes opgeslagen.
- AI-token
- Een brokstuk tekst, vaak een deel van een woord, waarin taalmodellen tekst opdelen om die efficiënt te kunnen verwerken.
- Byte Pair Encoding
- De gangbare techniek waarmee taalmodellen bepalen hoe tekst in tokens wordt opgedeeld, door veelvoorkomende lettercombinaties samen te voegen.
- Large language model
- Een groot taalmodel dat op enorme hoeveelheden tekst is getraind om mensachtige taal te begrijpen en te genereren.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.