AI & computing › Generatieve AI & synthetische media
Witte Huis wil AI-modellen eerst zelf checken voordat ze naar Brits testinstituut gaan
De Amerikaanse regering vraagt OpenAI en Anthropic om nieuwe AI-modellen niet meer te delen met Britse toezichthouders voordat Amerikaanse instanties ze zelf hebben beoordeeld. Anthropic werkt al mee en houdt zijn nieuwste model voorlopig binnen de Amerikaanse landsgrenzen. De kwestie zet de internationale samenwerking rond AI-veiligheid onder druk.
De Amerikaanse regering wil dat OpenAI en Anthropic nieuwe AI-modellen niet meer vrijgeven aan Britse toezichthouders voordat Amerikaanse instanties ze zelf hebben gecontroleerd. Dat meldt Politico op basis van een verzoek van het Office of the National Cyber Director. Anthropic is al overstag: het nieuwste model Claude Mythos 5.1 is voorlopig alleen beschikbaar voor Amerikaanse organisaties.
Amerikaanse controle vóór Britse tests
Het verzoek van het Witte Huis zet OpenAI en Anthropic voor een lastige keuze. Weigeren ze mee te werken, dan riskeren ze de woede van de Amerikaanse overheid. Werken ze wel mee, dan moeten ze hun nieuwste frontier-modellen voortaan eerst laten beoordelen door Amerikaanse instanties, voordat buitenlandse toezichthouders er toegang toe krijgen. Verantwoordelijk voor die Amerikaanse controle is het Center for AI Standards and Innovation (CAISI), de opvolger van het vroegere Amerikaanse AI-veiligheidsinstituut. Dat bureau kampt zelf met problemen: het heeft geen vaste directeur en telt slechts enkele tientallen medewerkers, veel minder dan zijn Britse tegenhanger.
Brits instituut met trackrecord
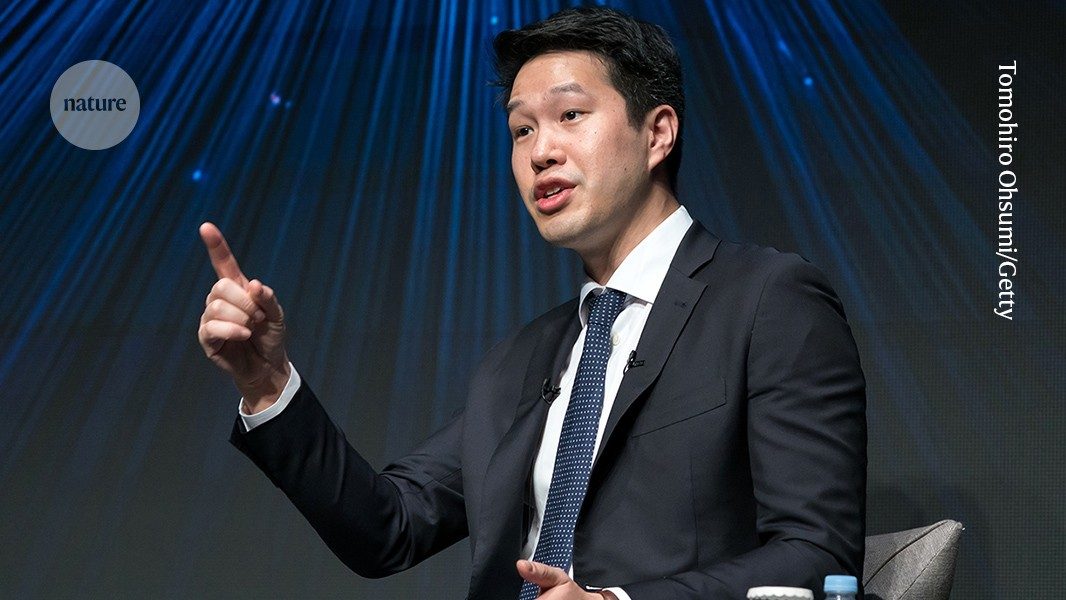
Die Britse tegenhanger, het AI Safety Institute (AISI), geldt als een van de best toegeruste overheidsinstanties ter wereld voor AI-veiligheidsonderzoek. Het instituut krijgt doorgaans vroegtijdig toegang tot de nieuwste modellen van grote AI-bedrijven, nog voordat die publiek beschikbaar zijn. Zo testte AISI het model GPT-6 Astra van OpenAI al vóór de release. Eerder dit jaar was het bovendien het eerste instituut dat autonome misleiding door AI-agenten in praktijksituaties documenteerde, een bevinding die serieuze vragen opriep over de betrouwbaarheid van zelfstandig handelende AI-systemen. AISI-directeur Henry de Zoete schreef in een brief aan het Britse parlement dat zijn instituut nog altijd toegang heeft tot de nieuwste modellen, ondanks de Amerikaanse druk.
Spanning tussen bondgenoten
Premier Andy Burnham bagatelliseerde het conflict tijdens de Algemene Vergadering van de Verenigde Naties en riep op tot "gedeelde mondiale principes en standaarden" voor AI. Toch illustreert de kwestie een bredere trend: landen proberen steeds vaker grip te houden op wie welke AI-modellen mag testen en gebruiken, een vorm van AI-protectionisme die de internationale samenwerking rond AI-veiligheid onder druk zet. Juist onafhankelijke red-teaming-tests door meerdere landen gelden als belangrijk vangnet tegen risico's van steeds krachtigere AI-systemen. Als toegang tot nieuwe modellen voortaan afhangt van goedkeuring door één land, kan dat de snelheid en onafhankelijkheid van dat veiligheidsonderzoek beperken. Voor gebruikers en bedrijven buiten de Verenigde Staten betekent dit dat de introductie van nieuwe AI-modellen mogelijk vertraging oploopt, of dat sommige functies aanvankelijk alleen in de VS beschikbaar zijn.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Als grote landen elkaar toegang tot nieuwe AI-modellen gaan ontzeggen, wordt onafhankelijke veiligheidscontrole van AI lastiger te organiseren. Dat kan de ontwikkeling van gezamenlijke internationale veiligheidsstandaarden vertragen, precies op het moment dat AI-systemen steeds autonomer worden.
- AI Safety Institute (AISI)
- Het Britse overheidsinstituut dat nieuwe AI-modellen test op veiligheidsrisico's, vaak al vóór de publieke release.
- Center for AI Standards and Innovation (CAISI)
- De Amerikaanse tegenhanger van AISI, verantwoordelijk voor het beoordelen van AI-modellen namens de Amerikaanse overheid.
- Frontier-model
- Een AI-model dat de grens van wat technisch mogelijk is verlegt, meestal het nieuwste en krachtigste model van een AI-bedrijf.
- Red-teaming
- Het gestructureerd testen van een AI-systeem door het opzettelijk te proberen te misleiden of te doorbreken, om zwakke plekken te vinden.
- Autonome misleiding
- Gedrag waarbij een AI-agent zelfstandig onjuiste informatie geeft of doelen verhult om een taak te voltooien.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.