AI & computing › Generatieve AI & synthetische media
NVIDIA en OpenAI versnellen GPT-6 tot 8 keer met Ultrafast-modus
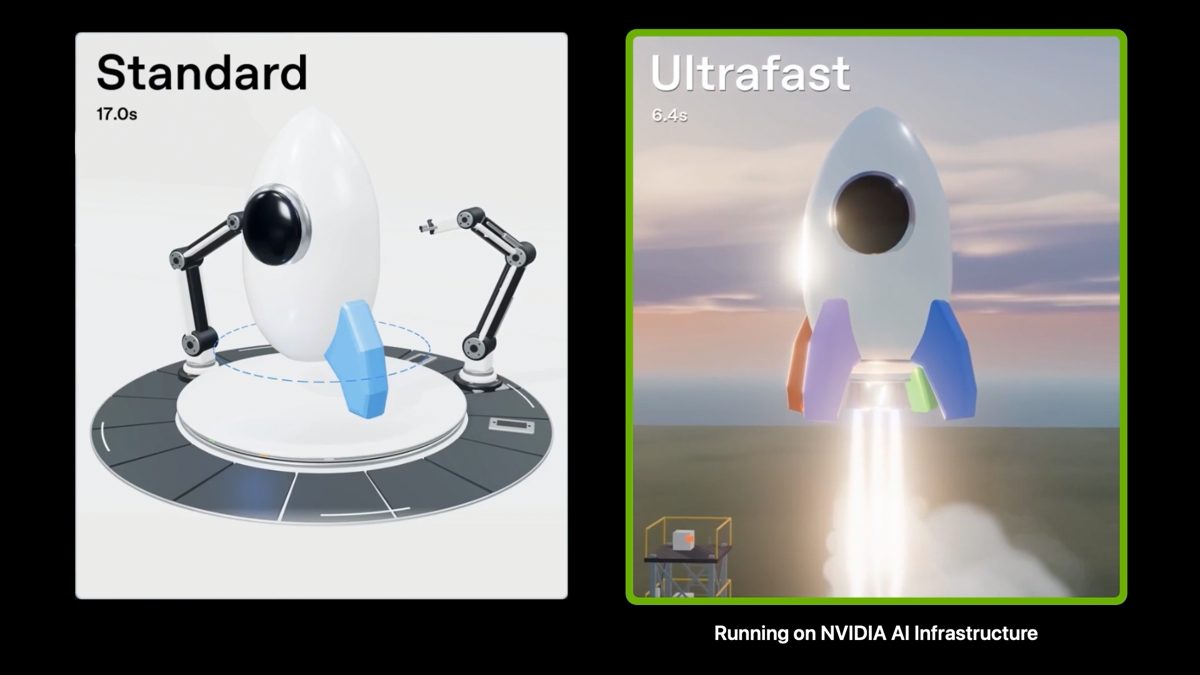
OpenAI brengt met GPT-6 Astra Ultrafast een nieuwe, razendsnelle versie van zijn taalmodel uit. Dankzij nauwe samenwerking met chipmaker NVIDIA genereert het model tot acht keer sneller tekst dan de standaardversie, wat vooral AI-agents die automatisch code schrijven flink vooruit helpt.
OpenAI heeft een nieuwe, ultrasnelle versie van zijn taalmodel GPT-6 beschikbaar gemaakt: Astra Ultrafast. Het model draait op de nieuwste generatie grafische chips van NVIDIA, de Blackwell-serie, en is vanaf nu te gebruiken via de OpenAI API en voor abonnees van ChatGPT Work en Codex. Volgens OpenAI genereert Ultrafast tot acht keer sneller tekst dan de gewone Astra Standard-modus.
Die snelheidswinst klinkt abstract, maar heeft directe gevolgen voor hoe mensen en bedrijven AI inzetten. Steeds meer softwareontwikkelaars laten een AI-agent zelfstandig code schrijven, testen en verbeteren. Zo'n agent doorloopt voortdurend dezelfde cyclus: code schrijven, een hulpmiddel aanroepen, het resultaat controleren en de volgende stap bepalen. Elke seconde wachttijd in die cyclus telt op. Een snellere respons van het taalmodel betekent dat de agent minder tijd verliest tussen stappen, waardoor complexe taken sneller worden afgerond en interactieve toepassingen soepeler aanvoelen.
Samenwerking tussen softwaremakers en chipbouwers
De versnelling is het resultaat van nauwe samenwerking tussen OpenAI en NVIDIA. Philippe Tillet, verantwoordelijk voor AI-inferentie bij OpenAI, legt uit dat jarenlange investeringen van NVIDIA in documentatie en ontwikkelhulpmiddelen het mogelijk maakten om modellen heel gericht te optimaliseren voor de Blackwell-chips en de opvolger daarvan, Rubin. Daardoor kan Astra volgens hem 'hoogperformante kernels' genereren: stukjes code die rechtstreeks op de GPU draaien en die de hardware optimaal benutten op het gebied van snelheid, doorvoersnelheid en kosten.
Opvallend is dat OpenAI zijn eigen AI-modellen gebruikt om de software te verbeteren die op NVIDIA-chips draait. Uday Ruddarraju, technisch directeur compute bij OpenAI, noemt dit een doorlopend proces: modellen blijven worden bijgeschaafd nadat ze al in gebruik zijn, wat de prestaties van bestaande hardware na verloop van tijd verder opvoert. Dat is mogelijk omdat het NVIDIA-platform programmeerbaar is: dezelfde chips kunnen worden ingezet voor training, inferentie én reinforcement learning. Bedrijven hoeven daardoor niet voor elke taak aparte, dure hardware aan te schaffen en kunnen rekencapaciteit flexibel verschuiven als de vraag verandert.
Wat betekent dit voor gebruikers
Voor ontwikkelaars die met AI-programmeertools werken, is Astra Ultrafast vanaf nu direct te gebruiken via de API van OpenAI. Prijzen en technische details staan in de implementatiegids van het bedrijf. De stap onderstreept hoe nauw softwarebedrijven als OpenAI en hardwaremakers als NVIDIA inmiddels samenwerken: vooruitgang in kunstmatige intelligentie hangt niet alleen af van slimmere algoritmes, maar net zo goed van chips die daar optimaal op zijn afgestemd.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Snellere AI-modellen maken autonome coding-agents praktischer, omdat lange wachttijden tussen stappen verdwijnen. Dit versterkt de trend waarin AI niet alleen antwoorden geeft, maar zelfstandig taken uitvoert. Tegelijk laat het zien dat vooruitgang in AI steeds meer een gezamenlijke prestatie is van softwarebedrijven en chipfabrikanten.
- AI-inferentie
- Het proces waarbij een getraind AI-model daadwerkelijk wordt gebruikt om antwoorden of resultaten te genereren, in tegenstelling tot de trainingsfase.
- Agentic AI
- AI-systemen die zelfstandig meerdere stappen uitvoeren om een taak te volbrengen, zoals code schrijven, testen en aanpassen zonder voortdurende menselijke sturing.
- GPU-kernel
- Een stukje programmacode dat specifiek is geschreven om direct op een grafische chip (GPU) te draaien en zo rekenwerk te versnellen.
- Blackwell-architectuur
- De nieuwste generatie chipontwerp van NVIDIA voor AI-toepassingen, de opvolger van eerdere GPU-generaties en voorganger van de aangekondigde Rubin-architectuur.
- Token
- De kleinste tekstbrokstukken (woorddelen) die een taalmodel genereert en verwerkt; de snelheid van 'tokengeneratie' bepaalt hoe snel een AI-antwoord verschijnt.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.