AI & computing › Generatieve AI & synthetische media
AI-scheidsrechters zijn het vaak eens, maar dat bewijst nog niets
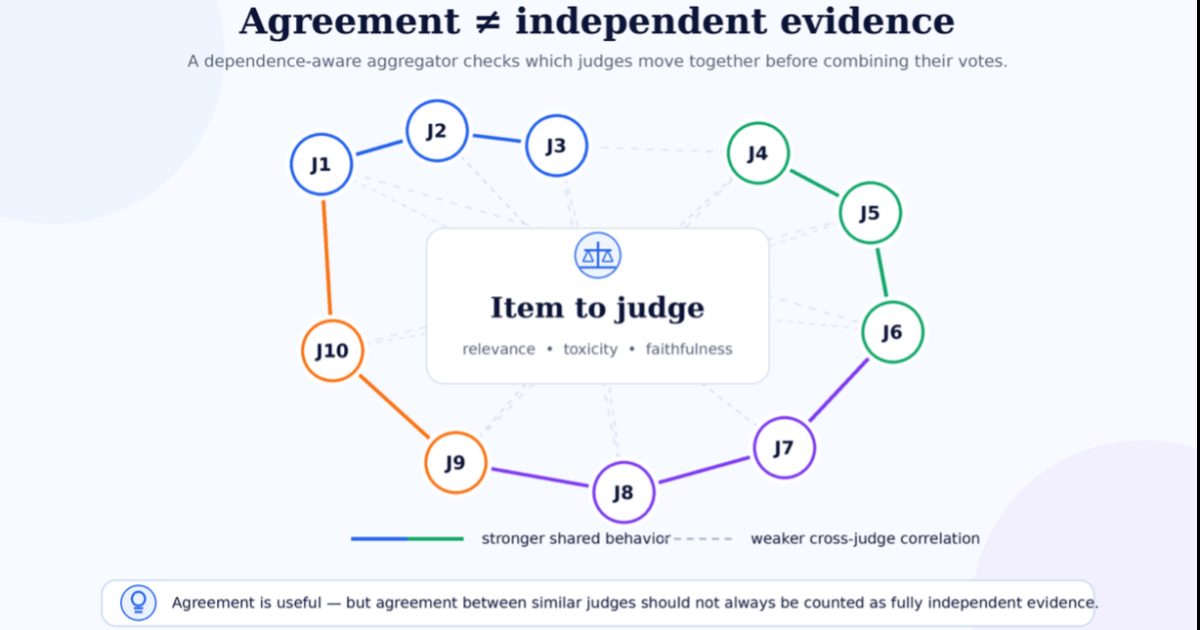
Onderzoekers van Amazon laten zien dat panels van AI-modellen die elkaars werk beoordelen, elkaar vaker napraten dan gedacht in plaats van onafhankelijk te oordelen. Hun nieuwe methode houdt daar rekening mee en blijkt tot 14 procent nauwkeuriger dan bestaande technieken.
Bedrijven die kunstmatige intelligentie bouwen, laten steeds vaker AI-modellen elkaars werk beoordelen. Zo'n arbiter-agent checkt bijvoorbeeld of een chatbot een giftige tekst produceert, of een zoekresultaat wel relevant is. Om de uitslag betrouwbaarder te maken, zetten ontwikkelaars vaak meerdere van die AI-rechters tegelijk aan het werk en tellen de stemmen. Onderzoekers van Amazon waarschuwen nu: die stemmen zijn vaak minder onafhankelijk dan ze lijken.
Acht stemmen, maar niet acht meningen
Stel: tien taalmodellen beoordelen of een zoekresultaat relevant is voor een vraag. Acht zeggen 'ja', twee zeggen 'nee'. Dat oogt overtuigend. Maar de onderzoekers, die hun werk presenteerden op de conferentie ICML, stellen een crucialere vraag: hoe onafhankelijk kwamen die acht modellen tot hun oordeel? Delen ze dezelfde trainingsdata, hetzelfde prompt-sjabloon of dezelfde onderliggende architectuur, dan is de kans groot dat ze ook dezelfde fout maken. Tien stemmen bevatten dan in werkelijkheid veel minder dan tien onafhankelijke bewijsstukken.
Gangbare methodes gaan daar te makkelijk aan voorbij. Bij een gewone meerderheidsstemming telt elke stem even zwaar. Een verbeterde versie, gewogen meerderheidsstemming, geeft historisch betrouwbaardere modellen meer gewicht. Beide technieken gaan er stilzwijgend van uit dat fouten van verschillende modellen los van elkaar ontstaan. Voor AI-rechters is die aanname vaak te optimistisch: ze delen nu eenmaal vaak bouwstenen.
Een panel als netwerk
Krishna Balasubramanian en Sasha Podkopaev, de onderzoekers achter het werk, stellen daarom voor om een panel van AI-rechters te behandelen als een netwerk in plaats van als losse individuen. Elk model krijgt nog steeds een eigen betrouwbaarheidsscore, maar daar komt een tweede laag bij: hoe sterk lijken twee modellen op elkaar in hun oordelen? Om die onderlinge afhankelijkheid wiskundig te vangen, gebruiken de onderzoekers een Ising-model, een statistisch model dat van oorsprong uit de natuurkunde komt en oorspronkelijk magnetische deeltjes beschrijft, maar zich ook leent voor het beschrijven van gekoppeld gedrag tussen willekeurige elementen — in dit geval AI-modellen.
De methode werkt zonder dat er menselijke labels nodig zijn om van te leren: het beschouwt het juiste antwoord als een onbekende grootheid en berekent tegelijk hoe waarschijnlijk elk antwoord is én hoe de modellen onderling samenhangen. Dat levert ook een vorm van onzekerheidskwantificering op: niet alleen een eindoordeel, maar ook hoeveel vertrouwen daarin gerechtvaardigd is.
Tot 14 procent nauwkeuriger
In tests op drie taken — het beoordelen van relevantie, het opsporen van giftige taal en het inschatten van de kwaliteit van samenvattingen — versloeg de nieuwe aanpak de beste bestaande methode met 9 tot 14 procent, bij panels van tien AI-rechters. Voor bedrijven die AI op grote schaal inzetten om andere AI te controleren, is dat relevant: verkeerde aannames over onafhankelijkheid kunnen leiden tot overmoedige, foutieve conclusies. De onderzoekers adviseren ontwikkelaars dan ook om de diversiteit van hun beoordelingspanels expliciet te meten, in plaats van blind te vertrouwen op het aantal stemmen.
Achtergrond & begrippen
Wat betekent dit voor de toekomst? Nu AI-systemen steeds vaker door andere AI-systemen worden gecontroleerd, groeit het risico dat die controle een schijnzekerheid biedt. Methodes die rekening houden met onderlinge afhankelijkheid tussen modellen maken geautomatiseerde kwaliteitscontrole betrouwbaarder, wat essentieel is naarmate mensen minder vaak elk AI-oordeel handmatig nakijken.
- LLM-as-a-judge
- De praktijk waarbij een taalmodel wordt ingezet om de output van een ander AI-systeem te beoordelen, bijvoorbeeld op relevantie of juistheid.
- Ising-model
- Een statistisch model, oorspronkelijk uit de natuurkunde, dat wordt gebruikt om afhankelijkheden tussen gekoppelde elementen te beschrijven.
- Meerderheidsstemming
- Een methode waarbij het antwoord met de meeste stemmen van een panel beoordelaars als uitkomst wordt gekozen.
- Gewogen meerderheidsstemming
- Een variant van meerderheidsstemming waarbij beoordelaars met een hogere historische nauwkeurigheid zwaarder meetellen.
- Label-aggregatie
- Het combineren van meerdere, mogelijk tegenstrijdige oordelen of labels tot één definitieve uitkomst.
Bronnen
Dit artikel is met behulp van AI geschreven op basis van bovenstaande bronnen en is geen letterlijke vertaling. Zo werkt onze redactie.